这段时间,身边的朋友和社区里聊得最多的焦虑之一,大概就是 Claude 和 OpenAI 的封号与风控。
有时候只是换了个网络节点、多端同时登录,或者付款卡片触发风控,早上打开终端或网页端,账号就已经用不了了。订阅费其实还是小事,大不了换一个号或者换一家模型;真正让人心疼的,是沉淀在账号和单一工具里的开发上下文——在 ChatGPT 里推演了半年的方案和笔记,在 Codex 里一轮轮排查过的 Bug、重构思路和本地记录。
账号一封,云端对话随时可能停在原地。哪怕你提前在 ChatGPT 里点过导出,拿到了一个官方 ZIP 压缩包,或者本机硬盘里还躺着 Codex 的 SQLite 和 JSONL 文件,它们本质上也只是“静态存档”:既不好搜索,也很难直接接回当前的项目目录里,换个模型继续往下聊。
与其等哪天真的被封号了再手忙脚乱,不如趁现在还能正常访问、数据都还在的时候未雨绸缪。最近我开源了一个 DeepSeek Harness 第三方插件:dsh-plugin-codex-import(当前版本 v0.13.2,MIT 协议),就是用来把这部分历史资产稳妥地接进我自己可控的本地环境里。
为什么选 DeepSeek Harness:多方 API 才是真正的退路
做迁移之前,我先想清楚了一个问题:把数据从 OpenAI 的体系里倒出来,如果只是换到另一个同样绑定单一账号的工具里,那遇到下一次风控还是会卡死。
我选择把历史对话迁入 DeepSeek Harness(dsh),最看重的是它本身是一个开放的、插件化的本地 Agent 运行时,而且在模型接入上不绑定任何单一厂商。
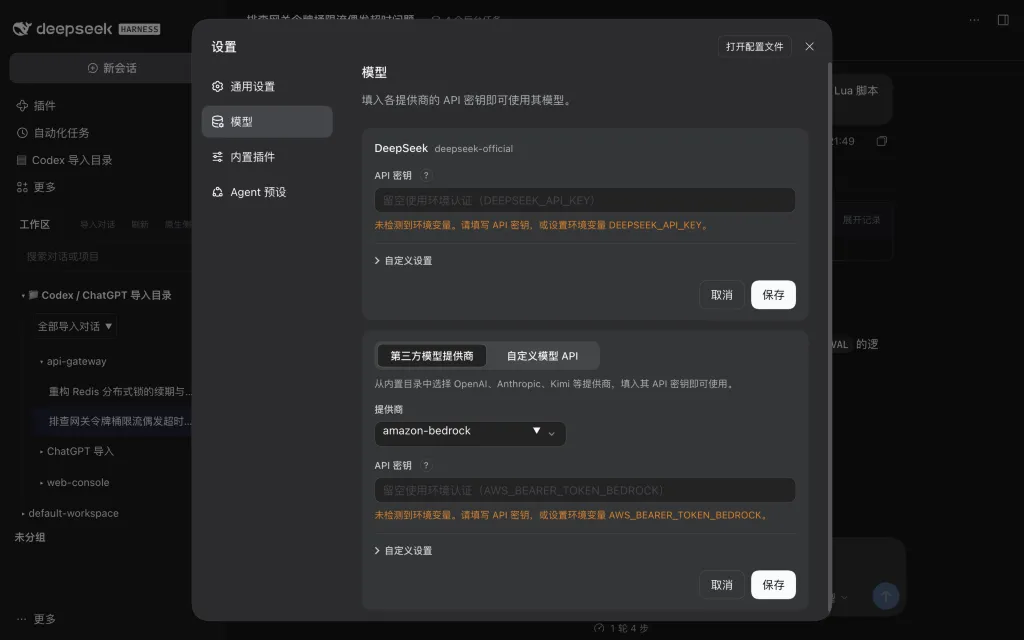
在 Harness 的 设置 → 模型 里可以看到,它除了原生支持 DeepSeek 官方 API 之外,还内置了对 OpenAI、Anthropic(Claude)、Kimi(Moonshot) 等第三方模型提供商的支持,并且允许直接配置自定义模型 API(比如兼容 OpenAI 协议的聚合网关、中转端点或本地模型)。所有 API 密钥都保存在本地 $DSH_HOME/.credentials.yaml,不依赖某一个云端订阅账号。
把 “历史上下文存储” 和 “具体调用哪家模型 API” 拆开之后,主动权就回到自己手里了:
- 平时把本地 Codex 记录和 ChatGPT 导出包同步进 Harness,作为自己的本地知识库与工程档案;
- 万一哪天某个 Claude 或 OpenAI 账号被封、限流或网络不可用,直接在 Harness 里切到 DeepSeek、Kimi 或者其他第三方兼容 API,打开原来的会话、沿着原项目目录和完整历史继续往下做,工作流不会因为一次封号而断掉。
这个插件实际怎么工作
dsh-plugin-codex-import 按照 Harness 官方的独立插件机制开发,不需要修改 Harness 源码,桌面版和 Web 版都可以直接安装使用。我自己在日常使用中,最在意的是省心、不破坏原有记录、而且读起来不乱。
同时支持本地 Codex 和 ChatGPT 导出包
在 Harness 左侧栏点击 「导入对话」,或者在任意会话框里输入 /codex-import preview,就会打开可视化导入向导:
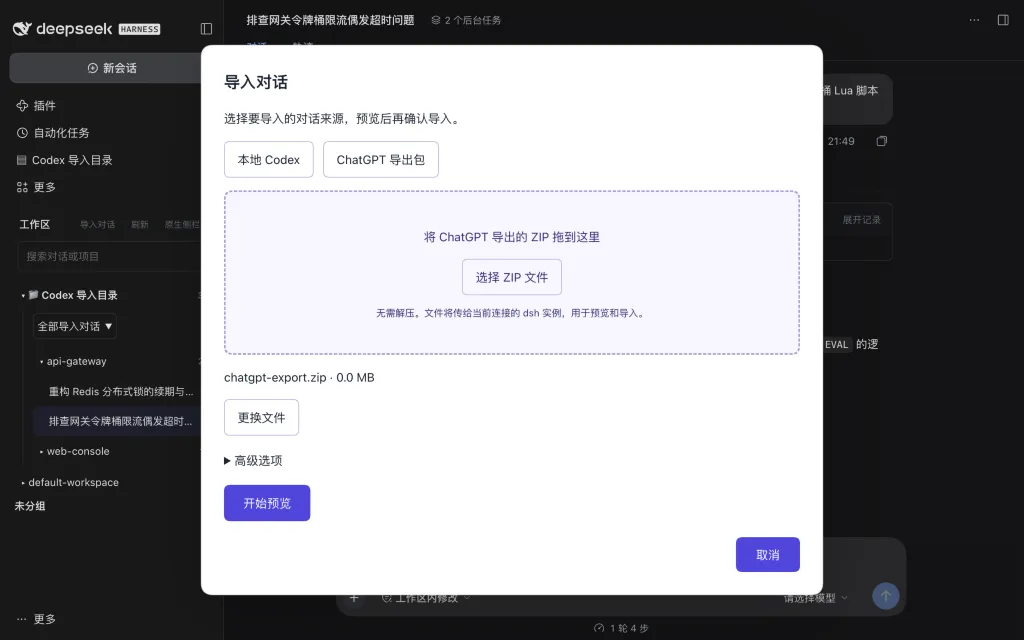
- 本地 Codex:自动发现当前
dsh实例所在机器上的 Codex 数据目录(优先读取 SQLite 正文,缺失时从 JSONL 补齐),无需手动拼接数据库路径; - ChatGPT 导出包:直接把官方导出的 ZIP 拖进窗口即可(也支持传入解压后的目录路径)。插件会逐片读取
export_manifest.json分片或conversations-*.json,按current_node还原当前对话分支,同时保留图片、文件、音频及转写内容,并把 ChatGPT 常见的<box>、<row>、表单和Cite引用整理成干净的原生排版。
点击「开始预览」后,插件会先统计新增与更新条数、可恢复的附件数量、缺失明细以及文本重合提示。确认之前不会向 Harness 写入任何会话,也不会复制附件,心里有底了再点确认。
按原项目收纳、复用工作目录,并保留你的续聊
导入完成之后,左侧栏会出现一个统一收纳的 「Codex 导入目录」(同时导入 ChatGPT 后会显示为「Codex / ChatGPT 导入目录」),内部按原本的项目分组,支持全量搜索标题、项目名、路径和原会话 ID,也支持按归档状态筛选。
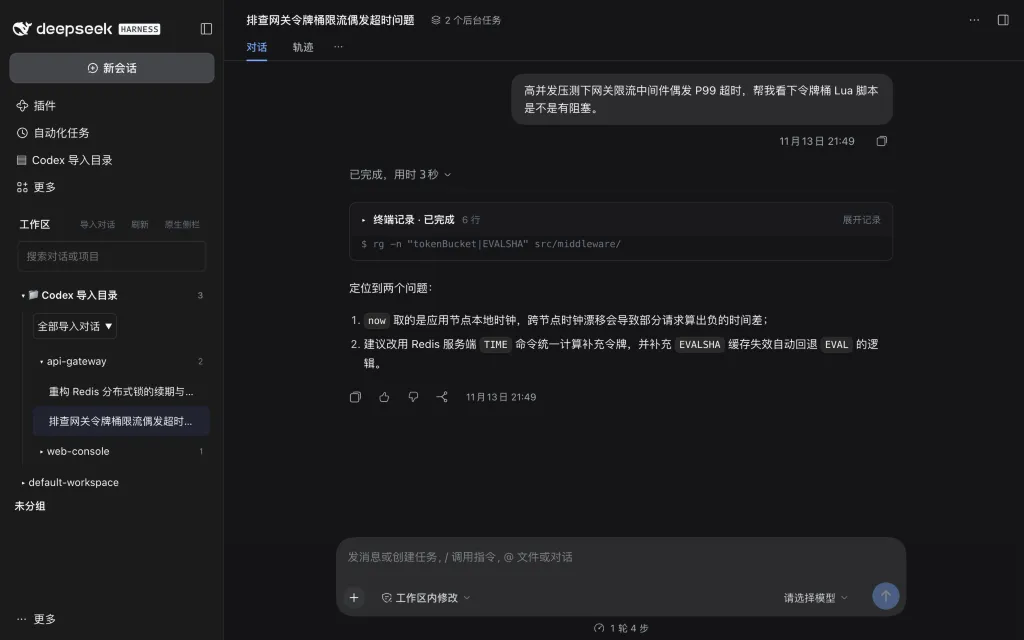
有几个细节我在设计时花了不少精力:
- 继续复用原项目目录:对于 Codex 对话,只要原项目路径在硬盘上依然存在,导入后的 Harness 会话就会直接绑定那个
cwd。打开历史会话后切个模型就能直接改代码;如果原目录已经删掉或移走,才会安全回退到专门的导入工作区。 - 增量同步不覆盖续聊:隔段时间有了新对话,跑一次
/codex-import sync,插件只会把新增或修订的记录追加到对应副本末尾。你在 Harness 里接着写下的新提问和回复会完整保留;如果某个会话正处于打开或运行状态,它会自动标记为“待重试”,不会重复生成一堆副本。 - 把历史读得更清爽:以前做开发留下的终端输出、工具调用日志、图片生成提示词通常非常长,默认会被收进折叠卡片里,需要核对细节时点开「展开记录」就能看到原文;长段的用户提问也可以自由展开、收起、调整字号和高度;结构化问答会还原成逐题对应的「问题与回答」卡片。
我特意画下的几条安全边界
既然做这个插件的初衷是为了应对封号风险、守住自己的对话资产,那插件本身就更不能乱碰敏感数据,也不能带来额外风险。整个插件遵循几条严格的边界:
- 绝对只读源数据,不碰账号凭据:插件只读取对话内容与可恢复的本地附件,绝不读取
auth.json或任何登录凭据,也不会修改你原来的 Codex 数据库或项目文件。 - 导入过程零模型调用:预览和写入全是本地数据转换,不会发起模型请求,不会重新执行历史命令或工具,也不会自动去下载远程 URL 附件。
- 数据格式向后兼容:来源信息保存在 Harness 可忽略的插件扩展事件里,核心对话都转换成原生消息。哪怕以后你不再用这个插件并卸载它,已经导入的会话在 Harness 里依然可以正常阅读。
- 清理可控:如果哪天想清理导入的记录,执行
/codex-import delete会先扫描并弹出确认窗口,只清理经过来源校验的导入副本,还可以选择保留已经有过 Harness 续聊的会话。
如何自己试一试
插件目前适配 DeepSeek Harness 0.2.2-rc.1(运行时需要 Node.js 24.9+,不过 Harness 桌面版已经自带运行时,不用单独折腾环境)。如果你想趁现在也把自己的对话资产备份一份,只需要三步:
- 在 ChatGPT 设置里申请一次 Export Data,把官方导出的 ZIP 存到本地;
- 到 GitHub Release 页面下载最新的安装包
dsh-plugin-codex-import-0.13.2.tgz(在 Harness 左侧 插件 → 安装第三方插件 中填入绝对路径即可,如果路径带空格记得加上file:前缀); - 启用插件重启后,点击侧栏「导入对话」或执行
/codex-import preview,先拿一两条会话或导出的 ZIP 预览体验一下,再把常用模型的 API Key 配好。
项目源码和完整使用手册都在 GitHub 上:
工具本身还在持续迭代,如果你在导入自己的 Codex 或 ChatGPT 历史时遇到边缘格式或者兼容问题,欢迎提 Issue 或一起交流(反馈前记得先对敏感对话内容做脱敏)。祝大家手里的每一次思考和每一段代码上下文,都不会因为一个账号的意外而丢失。
正在加载评论…